Whisper — нейросеть OpenAI, которая переводит речь из аудио в текст. С момента релиза в 2022 году её используют в сервисах расшифровки, плагинах для монтажа видео и системах субтитров. Разберём, как модель устроена внутри, почему качество меняется от записи к записи и как пользоваться облачной транскрибацией без видеокарты и командной строки.
Whisper обучили на большом массиве речи из интернета, но это не даёт единого процента точности для всех языков и записей. В EdWord можно проверить облачную транскрибацию на собственном файле: для аккаунта может быть доступен стартовый лимит.
Переведите запись в текст прямо здесь
Загрузите аудио или видео — вернётся текст с таймкодами и экспортом в TXT, DOCX, SRT или VTT. Файл до 2 ГБ и до 3 часов, бесплатный старт без карты.
Передача по HTTPS · файлы удаляются после обработки
Запись встречи загружайте здесь, на сайте: Telegram-бот принимает файлы до 20 МБ, а часовая запись весит больше.
Что такое Whisper
Whisper — открытая модель автоматического распознавания речи (ASR, automatic speech recognition), которую OpenAI опубликовала в сентябре 2022 года вместе с кодом и весами. Лицензия MIT позволяет использовать её где угодно, включая коммерческие продукты. Отсюда и взрыв популярности: любой разработчик может взять готовую модель и встроить речь-в-текст в своё приложение.
Модель мультиязычная: в обучающем корпусе 97 языков, так что на практике Whisper понимает речь примерно на сотне языков. Она сама определяет язык записи и расставляет пунктуацию — точки, запятые, заглавные буквы появляются в тексте автоматически. Для сравнения: классические ASR-системы прошлого поколения выдавали сплошной поток строчных слов, который потом приходилось размечать отдельным алгоритмом.
Whisper — модель многозадачная. Внутри одной сети упакованы четыре задачи: транскрибация речи на исходном языке, перевод речи на английский, определение языка и детекция голоса (VAD — понимание, есть ли в фрагменте речь вообще). Задача выбирается специальными токенами вроде <|transcribe|> и <|translate|>, поэтому испанский подкаст можно получить английским текстом за один проход, без промежуточного перевода.
Слово «whisper» переводится как «шёпот» (в рунете модель часто пишут кириллицей — «Виспер»). Ирония в том, что именно тихую и невнятную речь модель разбирает заметно лучше предшественников — сказалась манера обучения, о которой ниже.
680 000 часов аудио: на чём обучали модель
Главный секрет Whisper — масштаб и «грязнота» обучающих данных. OpenAI собрала из интернета 680 000 часов аудио с парными субтитрами: подкасты, лекции, интервью, ролики. Это примерно 77 лет непрерывного звучания. Около 117 000 часов — записи на языках, отличных от английского, и распределение там неравномерное: свыше тысячи часов набралось лишь у полутора десятков языков, а порядка 10 000 часов — только у пяти. Русский входит в эту пятёрку, поэтому по качеству распознавания он держится рядом с английским.
Академические ASR-модели до этого учились на вылизанных корпусах: студийный звук, дикторская речь, выверенная разметка. Такие модели показывали красивые цифры на тестах и разваливались на живых записях с эхом, перебиваниями и уличным шумом. Whisper учился сразу на «диком» аудио, поэтому реальный созвон в Zoom или голосовое из машины для него — привычная среда, близкая к обучающей выборке.
Обучение «со слабым надзором» (weakly supervised) означает, что субтитры из интернета никто вручную не выверял. Часть разметки была неточной, и модель научилась извлекать сигнал из шумных данных. Побочный эффект — устойчивость к акцентам, диалектам и специфической лексике, которой в стерильных корпусах попросту нет.
Как звук превращается в текст
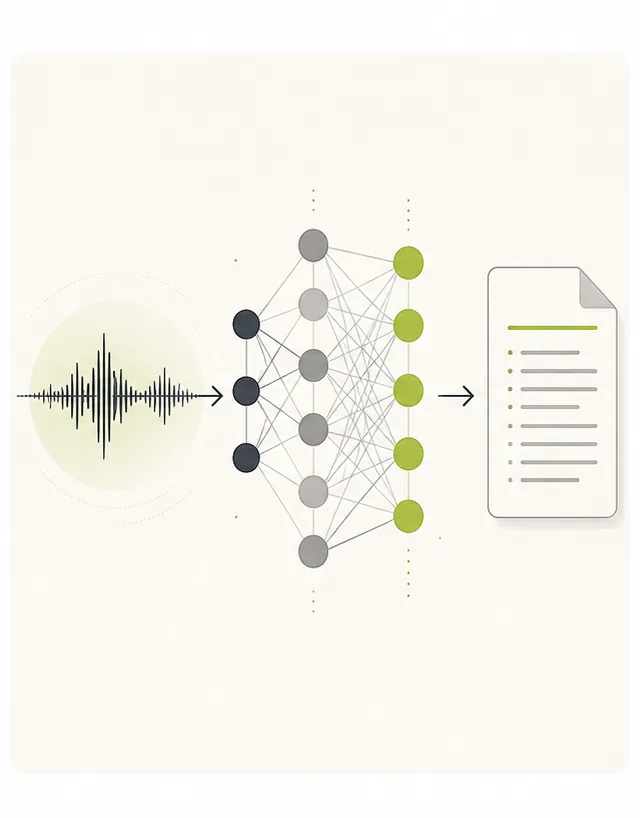
Внутри Whisper — трансформер типа «энкодер-декодер», та же архитектура, что у переводчиков и языковых моделей. Путь от звука до текста выглядит так:
- Нарезка. Аудио режется на фрагменты по 30 секунд. Длинная запись обрабатывается окнами, результаты сшиваются.
- Спектрограмма. Каждый фрагмент превращается в лог-мел-спектрограмму — по сути, картинку, где по горизонтали время, по вертикали частоты, а яркость показывает энергию звука. Нейросеть «смотрит» на звук как на изображение.
- Энкодер. Стек трансформер-блоков сжимает спектрограмму в набор векторов — внутреннее представление того, что было сказано.
- Декодер. Вторая половина сети генерирует текст токен за токеном, опираясь на векторы энкодера и уже напечатанные слова. Работает как автодополнение: предсказывает следующее слово с учётом контекста.
Контекстность декодера — причина, по которой Whisper грамотно пишет «прийти» вместо «придти» и восстанавливает смысл в местах, где звук смазан: модель опирается на языковую статистику, накопленную за время обучения. Подробнее о том, чем нейросетевой перевод аудио в текст отличается от старых движков распознавания, мы разбирали в отдельном материале.
Насколько хорошо Whisper понимает русский
Русский входит в группу языков, на которых Whisper показывает лучшие результаты — вместе с английским, испанским, немецким и итальянским. Причина простая: русскоязычного аудио в обучающей выборке было много.
Качество распознавания измеряют метрикой WER (word error rate) — долей заменённых, пропущенных и добавленных слов. Значение зависит от версии модели, языка, набора тестовых записей и методики подсчёта, поэтому без публичного benchmark нельзя переносить один процент на все файлы.
На практике модель уверенно разбирает:
- беглую разговорную речь со словами-паразитами и оборванными фразами;
- региональные акценты и речь людей, для которых русский второй язык;
- профессиональную лексику — медицинскую, юридическую, айтишную;
- записи с умеренным фоновым шумом: кафе, улица, клавиатура на созвоне.
Точность падает на плохом сигнале: перегруженный микрофон, сильная реверберация, несколько людей говорят одновременно. Технология распознавания речи в текст любит запись с расстояния 20–30 см от рта — это дешевле любых улучшений на этапе обработки.
Смешанная речь — рабочий сценарий для Whisper. Фраза «закинь фичу в бэклог, обсудим на дейли» распознаётся корректно: англицизмы внутри русского предложения модель видела в обучении тысячи раз.
Семейство моделей: от tiny до large
Whisper выпущен в нескольких размерах. Чем больше параметров, тем выше точность и тем медленнее обработка на том же железе.
| Модель | Параметры | Память | Скорость | Русский язык |
|---|---|---|---|---|
| tiny | 39 млн | ~1 ГБ | Очень быстро | Слабо, много ошибок |
| base | 74 млн | ~1 ГБ | Быстро | Терпимо для черновика |
| small | 244 млн | ~2 ГБ | Средне | Хорошо на чистом звуке |
| medium | 769 млн | ~5 ГБ | Медленно на CPU | Уверенно |
| large | 1,55 млрд | ~10 ГБ | Нужна GPU | Максимум качества |
Для русского языка разница между tiny и large драматична. Маленькие модели натренированы преимущественно на английском, и русская речь у них рассыпается на бессвязные слова. Серьёзная работа с русским аудио начинается с medium, а комфортное качество дают large-версии — именно модели этого класса крутятся под капотом ИИ-транскрибации EdWord.
Large-версия тоже развивалась: после исходной модели OpenAI выпустила large-v2, затем large-v3 с дополнительным дообучением, а следом облегчённую large-v3-turbo — она жертвует крохами качества ради кратного ускорения. Каждая итерация подтягивала качество на «неанглийских» языках, и русский выигрывал от этого заметнее многих. Параллельно сообщество ускоряло и расширяло модель: whisper.cpp и faster-whisper переписали вычисления так, что та же сеть работает в разы шустрее и влезает в более скромное железо, Whisper JAX распараллелил обработку длинных файлов на серверных ускорителях, а WhisperX добавил поверх точные таймкоды на каждое слово и связку с диаризацией — разметкой, кто из говорящих произнёс фразу.
Слабые места Whisper
Модель сильная, но у неё есть характерные болячки, о которых честно предупредить:
- Галлюцинации на тишине. Декодер обязан что-то генерировать, поэтому на длинных паузах и музыкальных вставках модель иногда «дописывает» фразы, которых никто не произносил. У русскоязычных записей набор известных фраз-подписей узнаваем: «Субтитры сделал DimaTorzok», «Редактор субтитров А.Синецкая», «Корректор А.Егорова», «Продолжение следует…», «Спасибо за просмотр!». Все они — артефакт обучения на субтитрах из интернета: модель запомнила титры, которыми люди подписывали свои переводы, и воспроизводит их там, где сказать нечего.
- Зацикливание. На очень плохом звуке декодер может застрять и повторять одну фразу несколько раз подряд. При локальном запуске это лечат подбором параметров: поднимают
temperature, отключают опору на предыдущий текст флагом--condition_on_previous_text Falseили подсказывают контекст через--initial_prompt— затравку с нужными терминами и именами. - Числа и имена. «Двадцать пять тысяч триста» модель может записать словами, цифрами или смесью. Редкие фамилии и названия компаний пишутся на слух.
- Спикеры не размечаются. Из коробки Whisper выдаёт единый поток текста без указания, кто говорит. Разделение по голосам — отдельная задача, которую решают другие инструменты.
- Таймкоды приблизительные. Метки времени привязаны к фразам и могут плавать на доли секунды — для субтитров хватает, для монтажа по миллисекундам стоит перепроверять.
Хорошая новость: большинство болячек лечится на уровне сервиса. Продакшен-системы поверх Whisper режут записи по паузам, фильтруют пустые сегменты, ловят зацикливания и склеивают куски так, чтобы фантомные фразы отсеивались до того, как попадут в итоговый текст. Пользователь этого слоя даже не видит — просто получает более чистую расшифровку, чем выдала бы «голая» модель из репозитория.
Вывод для практики: расшифровку важного интервью или юридической консультации стоит пробежать глазами, особенно места с числами, именами и датами. Пять минут вычитки против часа ручного набора — всё ещё огромный выигрыш.
Для чего используют Whisper
Технология одна, а сценариев вокруг неё десятки. Самые частые задачи, под которые берут Whisper и сервисы на его основе:
- Субтитры к видео. Модель выдаёт текст с таймкодами, из которого собирается готовый SRT- или VTT-файл для YouTube, VK Видео и монтажных программ.
- Интервью и подкасты. Журналисты и блогеры получают текстовую версию беседы за минуты и выбирают цитаты поиском по тексту вместо перемотки записи.
- Созвоны и переговоры. Расшифровка рабочего звонка фиксирует договорённости, задачи и ответственных — из неё быстро собирается протокол встречи.
- Лекции и вебинары. Студенты превращают запись пары в конспект, по которому удобно готовиться к экзамену и искать нужную тему.
- Голосовые сообщения. Длинные войсы в Telegram читаются текстом за секунды — этот сценарий целиком закрывает бот.
- Звонки в поддержку. Компании расшифровывают обращения клиентов, чтобы анализировать типовые проблемы и контролировать качество ответов операторов.
- Изучение языков. Двойные субтитры к иностранному ролику — оригинал плюс перевод — помогают разбирать живую речь на слух.
Запуск у себя или через сервис: сравнение
Whisper открыт, поэтому путей три: развернуть модель на своём железе, дёргать облачный API OpenAI из кода или загрузить файл в готовый сервис. Считаем честно.
Локальный запуск начинается с установки: pip install openai-whisper плюс ffmpeg для работы с медиафайлами, либо сборка whisper.cpp / faster-whisper без Python-окружения. Дальше потребуются видеокарта от 8–10 ГБ VRAM для large-модели (на процессоре часовая запись может обрабатываться несколько часов), место под веса и терпение на настройку зависимостей. Плюс — полный контроль: аудио остаётся на вашей машине, платить за минуты никому нужно.
Облачный API OpenAI снимает вопрос железа: отправляете файл запросом, получаете текст. Тариф — около $0,006 за минуту записи, то есть примерно $0,36 за час. Нюанс для России: оплата принимается зарубежной картой, поэтому напрямую из РФ этот путь затруднён и востребован в основном у разработчиков с валютными счетами.
| Критерий | Whisper у себя | API OpenAI | EdWord |
|---|---|---|---|
| Старт | Часы на установку | Ключ API и код | 2 минуты, браузер |
| Железо | GPU для large | Не нужно | Любой ноутбук, телефон |
| Час записи | От минут до часов | ≈$0,36, валютная карта | зависит от записи и нагрузки |
| Экспорт | Скриптами вручную | Текст и JSON в коде | TXT, DOCX, SRT, VTT кнопкой |
Локальная установка оправдана, когда записей десятки часов ежедневно, есть железо и инженер, который будет это поддерживать. Для остальных сценариев — совещание раз в неделю, лекции в сессию, интервью для статьи — сервис закрывает задачу быстрее, чем вы успеете скачать веса модели.
Расшифровка через EdWord: пошагово
EdWord выполняет распознавание на сервере; конкретная модель зависит от выбранного режима. Передать запись можно тремя способами.
Способ 1. Через сайт
- Откройте edword.ru и войдите через Telegram или Яндекс — для аккаунта может быть доступен стартовый лимит, карта не нужна.
- Перетащите файл в окно загрузки. Принимаются MP3, WAV, M4A, FLAC, OGG, WebM и видео MP4, AVI, MOV, MKV — до 2 ГБ.
- Дождитесь обработки: срок зависит от длительности записи, выбранного режима и текущей нагрузки; язык определяется автоматически.
- Заберите результат — скопируйте в один клик или скачайте в нужном формате. Расшифровка сохранится в истории личного кабинета.
Способ 2. Через Telegram-бот
Отправьте голосовое, кружок, аудио- или видеофайл боту @mywhisperedbot — текст придёт ответным сообщением. Бот живёт и в групповых чатах: добавьте его в рабочую группу, и каждое голосовое будет автоматически превращаться в текст под исходным сообщением.
Способ 3. По ссылке
Вставьте ссылку на видео с YouTube, VK Видео, Rutube и других площадок — сервис сам скачает ролик, вытащит дорожку и отдаст расшифровку. Удобно для лекций и вебинаров, которые лень выкачивать вручную.
Что получается на выходе
Результат — связный текст с пунктуацией, по желанию с таймкодами. Форматы экспорта под разные задачи:
- TXT — чистый текст для заметок и поиска по записи;
- DOCX — документ для правок в Word и согласований;
- SRT и VTT — готовые субтитры для YouTube, монтажных программ и плееров.
Из такого транскрипта легко собрать конспект лекции, протокол встречи или цитаты для статьи: текст структурирован по фразам, а таймкоды позволяют мгновенно вернуться к нужному месту записи. Для диктовки коротких заметок голосом есть отдельный инструмент — EdWord Mini работает прямо в браузере и ставится на компьютер как PWA-приложение.
Сколько стоит распознавание
Стартовый баланс может быть доступен, если доступен аккаунту. Дальше — разовые пакеты: час за 390 ₽, три часа за 990 ₽, десять часов за 2 990 ₽, пятьдесят — за 12 900 ₽. Командам подойдут пакеты 50 часов за 9 900 ₽ и 100 часов за 17 900 ₽. Подписки нет, купленные минуты лежат на балансе без срока сгорания — купили десять часов в июле, спокойно тратите их до зимы.
Итог
Whisper сделал качественное распознавание речи доступнее как открытая модель, которую можно запустить локально при наличии подходящего железа и навыков настройки. EdWord решает другую задачу: принимает файл в браузере или Telegram и выполняет обработку на сервере. Аккаунту может быть доступен стартовый лимит для проверки на собственных записях.